model: ai-talking-avatar 將一張人像與一段語音軌道轉換為唇形同步的說話影片。以非同步方式提交 GoEnhance API 任務,保存回傳的 img_uuid,然後輪詢或使用回呼來取得完成狀態。model: ai-talking-avatar 將一張人像與一段語音軌道轉換為唇形同步的說話影片。以非同步方式提交 GoEnhance API 任務,保存回傳的 img_uuid,然後輪詢或使用回呼來取得完成狀態。
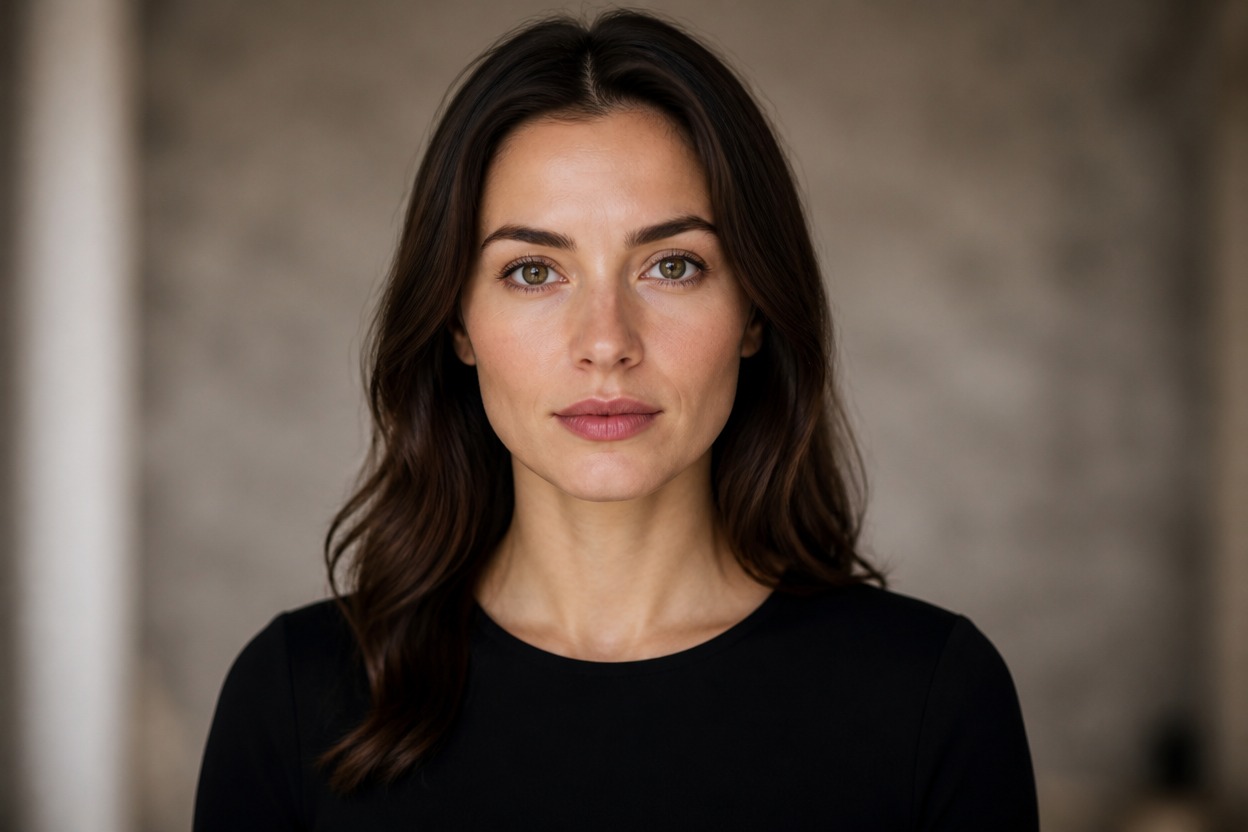
model 設為 ai-talking-avatar;這個必要值會選取 talking-avatar 工作流程。image_url,大小不超過 10MB,且臉部清晰可見、無遮擋。audio_url,長度為 3-60 秒且不超過 50MB。prompt 描述期望的說話表演;文件記載的預設值為 person talking。540p 或 720p。文件記載的預設值為 540p。img_uuid 並輪詢任務詳細端點以取得完成狀態。model: ai-talking-avatar,加入 image_url 和 audio_url,再選擇選用的提示詞與解析度。https://api.goenhance.ai/api/v1/videos/generations。請勿傳送 duration 欄位。img_uuid,然後輪詢 GET /api/v1/jobs/detail 或接收回呼事件。使用 model: ai-talking-avatar 傳送 POST https://api.goenhance.ai/api/v1/videos/generations,並附上公開的人像 image_url 與公開的 audio_url。
計費以測量到的音訊長度為準:540p 時每秒 0.5 個 token,720p 時每秒 1 個 token,分別等於每秒 $0.01 與 $0.02。
文件中列出的必填欄位為 model、image_url 與 audio_url。提示詞、解析度與回呼 URL 皆為選填。
不行。端點會拒絕 duration 欄位。輸出長度與計費皆依音訊檔案的測量長度而定。
人像最大 10MB。音訊長度須為 3-60 秒,且不得超過 50MB。請使用清晰語音,並確保臉部無遮蔽、大致面對鏡頭。
端點接受 540p 與 720p。若未指定,文件中記載的預設值為 540p。
保存 img_uuid 並輪詢 GET /api/v1/jobs/detail,或提供一個公開的 HTTPS 回呼 URL 以接收狀態變更。
本頁面說明透過 GoEnhance API 的獨立存取方式。它不主張任何上游合作關係、背書或官方關聯。